Jev Sau 3 Tuần: Chọn Provider Nào Cho Workflow n8n?
Ba tuần trước mình viết bài Jev & System One Model. Ở phần cuối có một đoạn mình khá chắc chắn:
Jev là dịch vụ đóng, của một công ty mới, đang early access, chỉ có một nhà cung cấp. Không có bản self-host, không có model thay thế tương đương để fallback.
Ba tuần sau, câu đó sai gần hết.
- 18/9 — OpenRouter đưa Jev lên dạng beta. Không cần waitlist nữa, có key OpenRouter là gọi được.
- 25/9 — OpenRouter ra thêm Jev Router, một thứ hoàn toàn khác mà nhiều người đang nhầm với Jev (mình sẽ nói ở dưới).
- 29/9 — Ollama 0.35 thêm endpoint
/v1/systemone, nói cùng “ngôn ngữ” với API của TypeSafe, kèm ba model chạy local:nimble(Bespoke Labs),tev1vàtev1:0.8b(Together AI). - 6/10 — OpenAI mở public beta cho Decisions API, cùng ý tưởng với Jev, chạy trên
gpt-6-luna. - Xen giữa là cả loạt dự án mã nguồn mở: Laya, Kev, OpenJev…
Câu hỏi giờ không còn là “Jev hay LLM” nữa. Nó là: gọi System One Model qua đâu, tốn bao nhiêu, và có nên kéo nó về chạy trên máy mình không. Bài này trả lời ba câu đó, theo góc nhìn của người build workflow n8n.
Toàn cảnh: 5 lựa chọn đang có
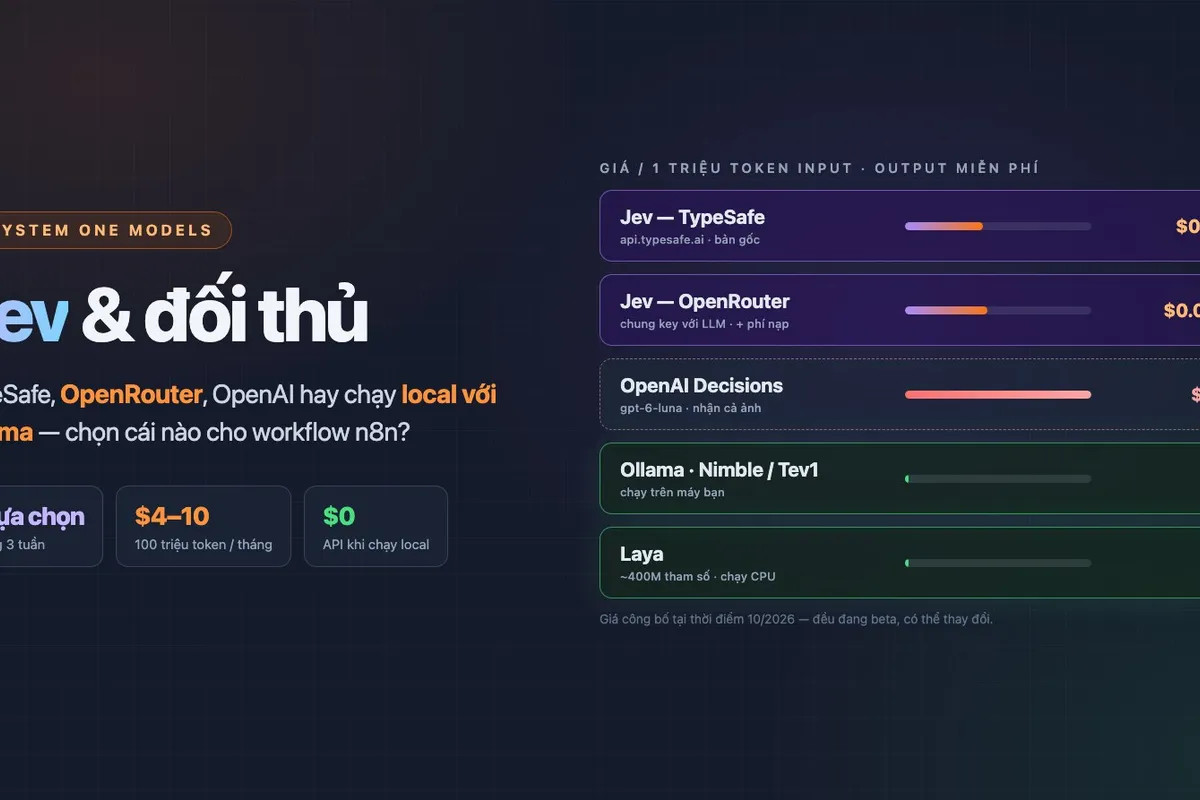
| Lựa chọn | Model | Endpoint | Giá input / 1M token | Đầu vào | Ghi chú |
|---|---|---|---|---|---|
| TypeSafe trực tiếp | jev-1.13.0 |
api.typesafe.ai/v1/systemone |
$0.042 | Text | Bản gốc |
| Jev qua OpenRouter | typesafe/jev-1.13 |
openrouter.ai/api/... |
$0.042 + phí nạp | Text | Beta, chung key với LLM |
| OpenAI Decisions | gpt-6-luna |
api.openai.com/v1/decisions |
$0.10 | Text + ảnh | Public beta, schema khác |
| Ollama (local) | nimble 9B, tev1 4B/0.8B |
localhost:11434/v1/systemone |
$0 | Text | Cần Ollama 0.35+ |
| Laya (local) | 322M – 421M tham số | laya-serve → /v1/systemone |
$0 | Text | Chạy được trên CPU |
Cả năm lựa chọn đều không tính tiền output. Đó là đặc điểm chung của dòng model này: đầu ra chỉ là vài con số xác suất, nên chẳng ai buồn tính phí.
Nhưng điều thú vị nhất trong bảng trên không nằm ở cột giá. Nó nằm ở cột endpoint.
Điều quan trọng nhất: tất cả (trừ OpenAI) nói chung một giao thức
TypeSafe, OpenRouter, Ollama và Laya đều chấp nhận cùng một body request: model + state + questions với ba kiểu choice / noul / score, và trả về cùng một cấu trúc answers. Request mẫu trên blog Ollama gần như y hệt request mình dùng trong bài trước — chỉ khác URL và tên model.
Với dân n8n, điều này có nghĩa là: đổi provider = đổi 3 giá trị, không phải viết lại workflow.
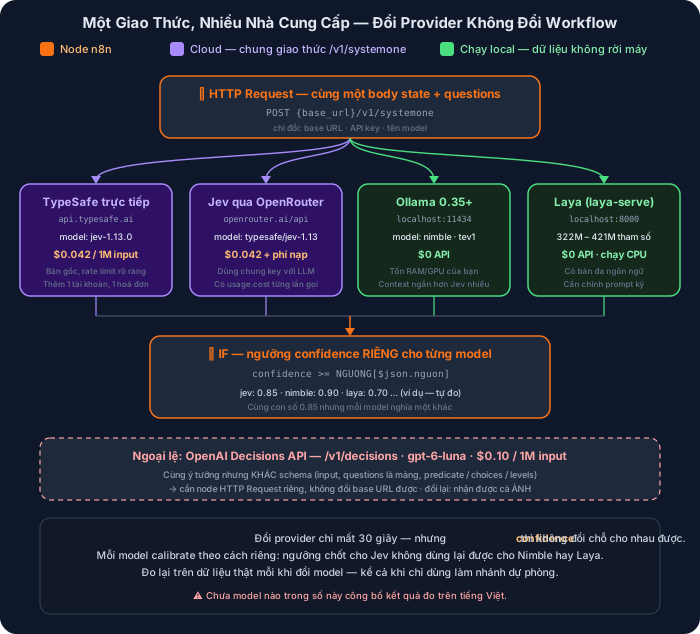
Cách mình setup: đặt một node Edit Fields (Set) tên Config ở đầu workflow:
{
  "base_url": "https://openrouter.ai/api",
  "model": "typesafe/jev-1.13",
  "nguon": "openrouter"
}
Rồi node HTTP Request dùng expression thay vì hard-code:
URL:   {{ $('Config').item.json.base_url }}/v1/systemone
Body:  "model": "{{ $('Config').item.json.model }}"
Muốn chuyển sang Ollama chạy local? Sửa Config thành http://host.docker.internal:11434 + nimble, đổi credential. Xong. Nếu bạn dùng bản n8n có tính năng Variables thì để mấy giá trị này trong $vars còn gọn hơn.
⚠️ Đừng vội mừng. Đổi provider thì dễ, nhưng ngưỡng confidence thì không mang theo được. Mình sẽ quay lại chuyện này ở phần cuối — đây là cái bẫy lớn nhất của cả bài.
Giờ đi vào từng lựa chọn.
Lựa chọn 1: Jev qua OpenRouter
Nếu bạn đã dùng OpenRouter cho các node LLM trong n8n, đây là con đường ít ma sát nhất để thử Jev.
Tại sao nên cân nhắc
- Không waitlist, không thêm tài khoản. Bài trước mình khuyên “đăng ký waitlist tại typesafe.ai”. Giờ chỉ cần key OpenRouter có sẵn credit là gọi được.
- Một hoá đơn. LLM và Jev chung một chỗ nạp tiền, chung một dashboard theo dõi chi phí.
- Mỗi response trả về luôn
usage.cost(tính bằng USD). Chi tiết nhỏ nhưng rất tiện: bạn ghi thẳng con số này vào Google Sheets sau mỗi lần chạy, cuối tháng biết chính xác từng workflow tốn bao nhiêu mà không cần ngồi nhân token với đơn giá.
Cấu hình trong n8n
Node HTTP Request:
- Method:
POST - URL:
https://openrouter.ai/api/alpha/decisions(endpoint chính thức trong tài liệu OpenRouter). OpenRouter cũng mở route tương thích TypeSafe tạihttps://openrouter.ai/api/v1/systemone— dùng route này nếu bạn theo patternConfigở trên. - Authentication → Header Auth:
Authorization=Bearer <OPENROUTER_API_KEY> - Body JSON: giữ nguyên
state+questionsnhư bài trước, chỉ đổimodel:
{
  "model": "typesafe/jev-1.13",
  "state": "Em đặt đơn 3 hôm rồi mà chưa thấy mã vận đơn, em cần gấp trước thứ 6 ạ",
  "questions": {
    "phan_loai": {
      "type": "choice",
      "instructions": "Which department should handle this ticket?",
      "criteria": {
        "ky_thuat": "Product bugs, system errors, login problems",
        "thanh_toan": "Invoices, refunds, cards, bank transfers",
        "van_don": "Order status, delivery, tracking number",
        "other": null
      }
    }
  }
}
Expression đọc kết quả giữ nguyên như bài trước: $json.answers.phan_loai.choice, $json.answers.phan_loai.confidence.
💡 Dùng
typesafe/jev-1.13(bản cố định) cho production, đừng dùng alias~typesafe/jev-latest. Lý do giống hệt bài trước: model nâng cấp có thể làm lệch phân phối confidence và phá ngưỡng bạn đã chốt. Response cũng trả về snapshot cụ thể đã phục vụ request (dạngtypesafe/jev-1.13-20260917) — nên log lại trường này.
Những điểm cần biết
- Phí nạp credit. OpenRouter không cộng thêm vào giá token, nhưng thu phí khi bạn nạp tiền — các nguồn tổng hợp năm 2026 đều ghi khoảng 5.5% cho thanh toán thẻ. Với Jev thì con số tuyệt đối gần như không đáng kể, nhưng nên biết. Kiểm tra lại tại trang pricing của OpenRouter trước khi tính ngân sách.
- Endpoint mang chữ
alpha. Đường dẫn chính thức là/api/alpha/decisions, và Jev được đánh dấu beta. Có thể đổi. - Jev không hiện trong danh sách model thông thường của OpenRouter, vì danh sách đó mặc định chỉ liệt kê model sinh text. Đừng hoảng nếu tìm không thấy.
- Context 32k token, cùng mức với TypeSafe trực tiếp.
Còn “Jev Router” là gì? (Không phải Jev)
Đây là chỗ mình thấy nhiều người nhầm nhất tuần qua.
typesafe/jev-router không trả về quyết định có kiểu. Nó là một model router chạy qua endpoint chat completions bình thường: bạn gửi tin nhắn như gửi cho LLM, bên trong Jev đọc hội thoại, đánh giá độ khó, rồi chọn model LLM nào và mức reasoning nào sẽ trả lời. Đặc điểm riêng là nó “cache-aware” — đổi model giữa chừng làm mất prompt cache, nên nó chỉ đổi khi lợi ích lớn hơn chi phí xử lý lại toàn bộ lịch sử hội thoại.
Trong n8n, bạn dùng nó qua node OpenRouter Chat Model gắn vào AI Agent, đặt model là typesafe/jev-router.
Hai lưu ý trước khi dùng:
- Giá niêm yết $0 không có nghĩa là miễn phí. Router không tính tiền, nhưng model mà nó chọn thì có. Chi phí thật nằm ở
usage.costcủa từng response. - Con số “giải được nhiều hơn 82% task so với Auto Router” là của OpenRouter tự công bố, tên benchmark và dữ liệu chi tiết chưa được công khai. Và với workflow production có prompt cố định, việc model trả lời thay đổi theo từng lượt có thể làm output kém nhất quán — đôi khi bạn muốn pin cứng một model hơn.
Nói gọn: Jev dùng để định tuyến dữ liệu trong workflow. Jev Router dùng để định tuyến chính các lần gọi LLM. Hai việc khác nhau.
Lựa chọn 2: OpenAI Decisions API — đắt gấp đôi, nhưng nhìn được ảnh
OpenAI vào cuộc chậm hơn ba tuần, đắt hơn khoảng 2.4 lần ($0.10 so với $0.042 cho mỗi triệu token input). Nhưng họ có một thứ mà cả Jev lẫn các bản local đều không có: nhận đầu vào là ảnh.
Nhớ bảng giới hạn trong bài trước không? “Đầu vào: chỉ text. Không ảnh”. Mình có nói workflow xử lý ảnh hoá đơn, chụp màn hình lỗi, ảnh sản phẩm thì Jev chưa vào được. Decisions API lấp đúng lỗ hổng đó.
Schema khác — đây là cái giá phải trả
OpenAI dùng cùng ý tưởng (ba loại câu hỏi, xác suất, confidence) nhưng không dùng chung giao thức:
| Khái niệm | Jev / Ollama / Laya | OpenAI Decisions |
|---|---|---|
| Dữ liệu đầu vào | state |
input (string, hoặc message có text + ảnh) |
| Danh sách câu hỏi | Object, key là tên câu hỏi | Mảng, mỗi phần tử có name |
| Câu hỏi có/không | noul |
predicate |
| Các lựa chọn | criteria (object) |
choices: mảng { value, description } |
| Thang điểm | criteria (mảng chuỗi) |
levels: mảng { label, description } |
| Câu trả lời | answers.ten_cau_hoi |
Mảng answers, phải tìm theo name |
| Từ chối trả lời | Không có | Có kiểu refusal |
Cùng ví dụ ticket ở trên, viết cho OpenAI:
{
  "model": "gpt-6-luna",
  "input": "Em đặt đơn 3 hôm rồi mà chưa thấy mã vận đơn, em cần gấp trước thứ 6 ạ",
  "questions": [
    {
      "type": "choice",
      "name": "phan_loai",
      "instructions": "Which department should handle this ticket?",
      "choices": [
        {
          "value": "ky_thuat",
          "description": "Product bugs, system errors, login problems"
        },
        {
          "value": "thanh_toan",
          "description": "Invoices, refunds, cards, bank transfers"
        },
        {
          "value": "van_don",
          "description": "Order status, delivery, tracking number"
        },
        { "value": "other", "description": "Anything else" }
      ]
    },
    {
      "type": "predicate",
      "name": "khan_cap",
      "instructions": "The customer expresses urgency or a time constraint."
    }
  ]
}
Vì answers là mảng, expression trong n8n phải dài hơn một chút:
{{ $json.answers.find(a => a.name === 'phan_loai').choice }}
{{ $json.answers.find(a => a.name === 'phan_loai').confidence }}
{{ $json.answers.find(a => a.name === 'khan_cap').probability }}
Và đừng quên nhánh refusal: nếu một câu trả lời có type là refusal, đưa thẳng vào hàng đợi người duyệt. Đừng để expression ở trên âm thầm trả về undefined rồi node Switch rẽ bừa.
Về credential: HTTP Request node cho phép chọn Predefined Credential Type → OpenAI, dùng lại luôn credential OpenAI bạn đã có. URL: https://api.openai.com/v1/decisions.
Gửi ảnh từ n8n
Decisions API chỉ nhận ảnh dưới dạng base64 nhúng thẳng trong request — không nhận URL ảnh, không nhận file ID. Trong n8n:
- Lấy file ảnh (từ Gmail attachment, Telegram, Google Drive…)
- Node Extract From File → thao tác Move File to Base64 String
- Đưa chuỗi đó vào
inputdạng message gồm hai phầninput_textvàinput_image(ảnh ở dạng data URLdata:image/jpeg;base64,...). Cấu trúc chính xác xem trong tài liệu Decisions API của OpenAI.
Use case mình thấy đáng thử nhất: ảnh chụp biên lai chuyển khoản khách gửi qua Zalo/Telegram → hỏi “đây có phải biên lai chuyển khoản hợp lệ không” (predicate) + “ngân hàng nào” (choice) → confidence thấp thì chuyển người duyệt.
Còn lại cần biết
- Đang public beta, chưa GA. Giá $0.10 chưa chắc giữ nguyên khi chính thức ra mắt.
- Có phụ phí cho xử lý dữ liệu theo vùng (regional processing) và cho request context rất dài — đọc kỹ trang pricing nếu bạn có yêu cầu lưu trữ dữ liệu tại EU/Mỹ.
- Có hỗ trợ Zero Data Retention cho khách hàng đủ điều kiện — điểm cộng nếu bạn làm với dữ liệu nhạy cảm mà vẫn muốn dùng cloud.
- OpenAI tự công bố “nhanh hơn khoảng 10 lần so với gọi GPT-6 Luna qua Responses API”. Chưa có đo đạc độc lập.
Lựa chọn 3: Chạy local với Ollama — Nimble và Tev1
Đây là phần mình hào hứng nhất, vì nó trả lời đúng câu hỏi cuối bài trước: có cách nào gọi một “Jev” mà dữ liệu không rời khỏi máy mình không?
Có. Và nếu bạn đã setup theo bài tích hợp n8n với Ollama, bạn đã đi được 80% đường.
Ba model hiện có
| Model | Kích thước | Dung lượng tải | Nhà phát triển | Context mỗi lần chấm | Ghi chú |
|---|---|---|---|---|---|
nimble |
9B | ~9.5 GB | Bespoke Labs | 8.192 token | Apache 2.0, fine-tune từ Qwen3.5-9B |
tev1 |
4B | ~4.5 GB | Together AI | ~2.000 token | Thử nghiệm (experimental) |
tev1:0.8b |
0.8B | ~800 MB | Together AI | ~2.000 token | Thử nghiệm, nhẹ nhất |
Hãy nhìn kỹ cột context. Jev cho bạn 32k token cho state. nimble chỉ 8k, tev1 chỉ khoảng 2k. Nghĩa là: một email dài kèm cả chuỗi reply bên dưới, hoặc một transcript hội thoại vài chục lượt — có thể không vừa. Với tev1, cứ coi như chỉ phù hợp với tin nhắn ngắn, comment, tiêu đề ticket. Bài toán cần đọc tài liệu dài thì vẫn phải là Jev (hoặc tự cắt bớt state trước khi gửi).
Độ chính xác so với Jev
Bespoke Labs đã chạy so sánh trên 13 bộ dữ liệu công khai có nhãn do người gán (3.880 quyết định), con số được đăng trên trang model của Ollama:
| Model | Độ chính xác trung bình |
|---|---|
| Jev 1.13 | 76.0% |
| Nimble 9B | 75.7% |
| Tev1 4B | 73.3% |
| Tev1 0.8B | 63.5% |
Nhìn qua thì Nimble gần như ngang Jev, và còn vượt Jev ở nhóm câu hỏi score (54.6% so với 50.1%). Nhưng nhớ: đây là benchmark do chính Bespoke Labs chạy — đơn vị làm ra Nimble. Và tất cả đều là dữ liệu tiếng Anh (có một bộ tiếng Đức). Tev1 0.8B thì tụt hẳn xuống, đổi lại nhẹ đủ để chạy trên máy yếu.
Cấu hình trong n8n
Bước 1 — Cập nhật Ollama lên 0.35 trở lên và tải model:
ollama pull nimbleBước 2 — Node HTTP Request:
- Method:
POST - URL:
http://localhost:11434/v1/systemone— hoặchttp://host.docker.internal:11434/v1/systemonenếu n8n chạy trong Docker (xem lại bảng địa chỉ trong bài n8n + Ollama) - Authentication: không cần
- Body: y hệt request gửi cho Jev, chỉ đổi
"model": "nimble"
Response cũng có cấu trúc answers giống Jev, nên node IF và Switch phía sau giữ nguyên. Riêng câu hỏi score có thêm trường legend cho biết mỗi mức điểm tương ứng nhãn nào — tiện khi debug.
Nếu bạn viết script Python bên ngoài n8n, SDK chính thức của TypeSafe (typesafe-sdk) cũng trỏ được vào Ollama: đặt TYPESAFE_BASE_URL=http://localhost:11434 và TYPESAFE_API_KEY=ollama.
⚠️ n8n Cloud không gọi được vào
localhostcủa máy bạn. Muốn dùng lựa chọn local, n8n phải được self-host — cùng máy hoặc cùng mạng nội bộ với Ollama.
Còn phần cứng thì sao?
Ollama công bố Nimble đạt trung bình 91ms mỗi quyết định — nhưng đo trên MacBook Pro M5 Max, một cỗ máy rất mạnh. Mình chưa có số đo đáng tin cho cấu hình phổ thông, nên nói thật là: bạn phải tự đo. Một vài nguyên tắc chung:
- Nimble 9B cần máy có đủ RAM/VRAM để chứa ~9.5GB model. Mac Apple Silicon 16GB trở lên, hoặc PC có GPU tầm trung là hợp lý.
- Tev1 4B dễ thở hơn nhiều.
- Tev1 0.8B là ứng viên duy nhất trong ba model có khả năng chạy chấp nhận được trên một con VPS chỉ có CPU — đổi lại độ chính xác thấp hơn rõ rệt.
Lựa chọn 4: Laya — nhỏ, chạy CPU, có bản đa ngôn ngữ
Laya là dự án mã nguồn mở (Apache 2.0) đi theo hướng ngược lại hoàn toàn với Nimble: thay vì fine-tune một LLM 9B, nó dùng backbone kiểu BERT, chỉ 322M – 421M tham số. Chạy được trên CPU, GPU, Apple Silicon.
Ba điểm làm Laya đáng chú ý với người dùng Việt:
- Có bản
laya-multilingual(backbone mmBERT, 322M tham số), tác giả ghi hỗ trợ hơn 100 ngôn ngữ. Đây là model duy nhất trong bài chủ động nhắm tới đa ngôn ngữ. Tuy nhiên bảng benchmark của họ phủ 51 ngôn ngữ và không nêu tên tiếng Việt — đừng mặc định là nó tốt với tiếng Việt. - Server
laya-servedùng cùng giao thức/v1/systemonevới Jev. README nói thẳng: client đang gọi Jev chỉ cần trỏ lại base URL. Tức là nó cắm được vào patternConfigở đầu bài. - Nhanh và nhẹ. Tác giả đo khoảng 33ms cho một câu hỏi trên GPU T4, và khoảng 450ms trên một máy Intel chỉ có CPU.
Nhưng có một bài đo độc lập mà bạn nên đọc trước khi chọn Laya. Đội ngũ Red Hat đã so Jev, Laya và một loạt classifier, LLM-as-judge truyền thống trên hai bài toán guardrail (phát hiện prompt injection và kiểm duyệt nội dung độc hại), dữ liệu tiếng Anh:
| Model | Prompt injection | Kiểm duyệt nội dung |
|---|---|---|
| Jev 1.13 | 86.35% | 86.20% |
| Laya | 85.44% | 57.87% |
| Laya (sau khi chỉnh prompt) | — | 75.20% |
| deberta-v3 (classifier riêng) | 89.01% | — |
Laya theo sát Jev ở bài toán thứ nhất, nhưng sụp hẳn ở bài toán thứ hai cho tới khi được chỉnh prompt kỹ. Và chi tiết thú vị nhất: chính cái prompt đã chỉnh để Laya lên 75.20% lại làm Jev tụt từ 86.20% xuống 82.53%. Prompt tối ưu cho model này không mang sang model kia được.
💡 Ngoài Laya còn có Kev (dựng trên Qwen 3.5, Apache 2.0, nhắm làm bản thay thế Jev tự host) và vài dự án nhỏ hơn. Mình chưa thấy số đo độc lập đủ tin cậy cho chúng, nên chưa đưa vào so sánh.
Chuyện tiền nong: so sánh thật
Giữ nguyên kịch bản bài trước: 100.000 ticket mỗi tháng, mỗi ticket ~1.000 token → 100 triệu token input/tháng. Thêm một kịch bản lớn gấp 10 lần để thấy xu hướng.
| Lựa chọn | 100M token/tháng | 1 tỷ token/tháng |
|---|---|---|
| TypeSafe trực tiếp | $4.20 (~110.000đ) | $42 (~1,1 triệu đ) |
| Jev qua OpenRouter (+5.5% nạp) | ~$4.43 (~116.000đ) | ~$44 (~1,16 triệu đ) |
| OpenAI Decisions | $10.00 (~262.000đ) | $100 (~2,6 triệu đ) |
| Ollama / Laya (local) | $0 API + điện + phần cứng | $0 API + điện + phần cứng |
| LLM rẻ nhất (tham chiếu) | từ $20 + tiền output | từ $200 + tiền output |
(Quy đổi ~26.200đ/USD. Dòng LLM lấy mức giá input thấp nhất $0.20/1M token trong bài trước.)
Đọc bảng này, mình rút ra một kết luận có thể hơi ngược với kỳ vọng:
Ở mức giá $4/tháng, chạy local gần như không bao giờ thắng về tiền.
Một tháng Jev cho 100.000 ticket rẻ hơn một bữa trưa. Nếu bạn phải thuê thêm VPS có GPU, hay mua máy mới chỉ để chạy Nimble, thì phải lên tới hàng tỷ token mỗi tháng mới hoà vốn. Còn nếu bạn đã có sẵn một con Mac Apple Silicon hoặc máy có GPU đang chạy n8n thì chi phí biên gần như bằng tiền điện — nhưng kể cả vậy, khoản tiết kiệm cũng chỉ là vài trăm nghìn đồng một tháng.
Vậy lý do để chạy local là gì? Không phải tiền. Mà là những thứ sau:
- Dữ liệu không được phép rời khỏi hệ thống. Thông tin khách hàng, hồ sơ y tế, dữ liệu tài chính, hợp đồng nội bộ. Đây là lý do mạnh nhất, và là lý do chính đáng duy nhất trong nhiều trường hợp.
- Không có rate limit. Jev giới hạn 1.200 request/phút. Ở local, giới hạn là phần cứng của bạn.
- Không phụ thuộc nhà cung cấp. Không lo đổi giá, không lo dịch vụ beta bị khai tử, không lo mất mạng.
- Chạy offline, chạy trong mạng nội bộ cho những môi trường không được ra Internet.
Còn chênh lệch giữa ba lựa chọn cloud thì sao? OpenAI đắt gấp 2.4 lần Jev — nhưng ở quy mô này, chênh lệch tuyệt đối chỉ là vài USD. Hãy chọn theo năng lực (có cần ảnh không? cần ZDR không? độ chính xác trên dữ liệu của bạn?) chứ đừng chọn theo giá. Giá rẻ tới mức không còn là yếu tố quyết định nữa — đúng tinh thần nghịch lý Jevons mà mình đã nói ở bài trước.
Pattern nâng cao: local trước, cloud dự phòng
Bài trước mình khuyên “đừng để workflow chết nếu Jev chết”, nhưng hồi đó chỉ có cách rơi về Text Classifier hoặc đẩy hết sang người duyệt. Giờ có lựa chọn tốt hơn: hai System One Model dự phòng cho nhau.
Trigger
  └─> HTTP Request (Ollama · nimble)        [Settings → On Error: Continue (using error output)]
        ├─ success → Set: nguon = "nimble"   ──┐
        └─ error   → HTTP Request (OpenRouter · jev-1.13)
                        └─> Set: nguon = "jev" ─┤
                                                └─> IF (ngưỡng theo nguon) → Switch / Human review
Dữ liệu ưu tiên xử lý tại chỗ; chỉ khi máy local quá tải hoặc chết thì mới gửi ra cloud. Nếu chính sách dữ liệu của bạn cấm tuyệt đối việc gửi ra ngoài, thì đảo lại: nhánh error đi thẳng vào hàng đợi người duyệt, không gọi cloud.
Và giờ là chỗ quan trọng nhất của cả bài.
Cái bẫy: ngưỡng confidence không mang theo được
Bạn đã chạy song song 2 tuần, đo được rằng với Jev, ngưỡng 0.85 cho độ chính xác 95%. Giờ nhánh dự phòng là Nimble. Bạn giữ nguyên 0.85?
Không được. Mỗi model tính confidence theo một cách khác nhau. README của Laya nói thẳng: confidence của nó được tính khác Jev, ngưỡng của Jev không dùng được cho Laya. Bài đo của Red Hat cho thấy ngay cả prompt cũng không chuyển giao được giữa các model. “0.85 của Jev” và “0.85 của Nimble” là hai con số không cùng thang đo.
Đó là lý do trong sơ đồ ở trên, node IF dùng ngưỡng riêng cho từng nguồn:
{{ $json.answers.phan_loai.confidence >= ({ "jev": 0.85, "nimble": 0.90, "laya": 0.70 })[$json.nguon] }}Mấy con số trên chỉ là ví dụ — ngưỡng thật phải đo cho từng model trên dữ liệu của bạn. Để ý mình dùng trường nguon tự đặt ở node Set, chứ không dùng trường model trong response: OpenRouter trả về tên snapshot kiểu typesafe/jev-1.13-20260917, sẽ đổi theo thời gian và làm hỏng bảng tra.
Và phần không màu hồng
Tiếng Việt: vẫn chưa ai đo
Ba tuần trước, giới hạn lớn nhất của Jev với người Việt là tài liệu chỉ cam kết chất lượng cho tiếng Anh. Ba tuần sau, tình hình không khá hơn:
- Nimble — trang model không nêu ngôn ngữ hỗ trợ.
- Tev1 — Together AI nói rõ chưa thử nghiệm ngôn ngữ nào ngoài tiếng Anh.
- Laya multilingual — nhắm đa ngôn ngữ, nhưng bảng benchmark không có tiếng Việt.
- OpenAI Decisions — không công bố. Về lý thuyết, nền tảng là một LLM đa ngôn ngữ nên có thể có lợi thế, nhưng đó là suy đoán của mình, chưa được kiểm chứng.
Tin tốt là: nhờ chung giao thức, việc tự benchmark giờ rẻ hơn bao giờ hết. Lấy 200–500 mẫu tiếng Việt đã gán nhãn tay, chạy qua 2–3 ứng viên chỉ bằng cách đổi node Config, ghi kết quả vào Sheets, so sánh cả độ chính xác lẫn calibration. Một buổi chiều là xong. Đừng chọn model dựa vào bảng benchmark tiếng Anh của người khác.
Benchmark phần lớn vẫn do người trong cuộc chạy
- Bảng so sánh Nimble / Tev1 / Jev là do Bespoke Labs chạy — chính họ làm ra Nimble.
- Con số của Jev Router là do OpenRouter công bố.
- Tốc độ của Decisions API là do OpenAI công bố.
Bài đo độc lập đáng kể nhất cho tới giờ là của Red Hat, và kết luận của họ khá phũ: các decision model chưa chứng minh được là nhanh hơn, rẻ hơn hay chính xác hơn LLM-as-a-judge một cách nhất quán, và các classifier chuyên dụng kiểu cũ (như deberta cho prompt injection) vẫn rất cạnh tranh — đạt độ chính xác cao nhất nhì với độ trễ chỉ khoảng 54ms. Nếu bài toán của bạn hẹp và đã có sẵn classifier được huấn luyện cho đúng việc đó, có khi bạn chẳng cần System One Model nào cả.
Mọi thứ đều đang beta
OpenRouter: beta, endpoint alpha. OpenAI: public beta, chưa có ngày GA, giá có thể đổi. Tev1: “experimental”. Ollama nói đây là “bản đầu tiên trong nhiều bản”. Ba tuần trước chưa có gì; ba tuần nữa bức tranh có thể lại khác. Pin version, giữ nhánh dự phòng, và đừng xây cả hệ thống quanh một API mang chữ alpha trong URL.
Vậy rốt cuộc, chọn cái nào?
| Tình huống của bạn | Nên chọn |
|---|---|
| Đã dùng OpenRouter cho LLM, muốn thử Jev nhanh nhất | ✅ Jev qua OpenRouter |
| Production lưu lượng lớn, cần rate limit và hỗ trợ rõ ràng | ✅ TypeSafe trực tiếp |
| Cần phân loại ảnh: hoá đơn, biên lai, ảnh chụp màn hình | ✅ OpenAI Decisions API |
| Đã ở trong hệ sinh thái OpenAI, cần ZDR / data residency | ✅ OpenAI Decisions API |
| Dữ liệu nhạy cảm, không được rời hệ thống | ✅ Ollama + Nimble (máy đủ mạnh) |
| VPS chỉ có CPU, chấp nhận độ chính xác thấp hơn | ✅ Laya hoặc Tev1 0.8B |
| Dữ liệu đầu vào dài (email dài, transcript, tài liệu) | ✅ Jev — context local quá ngắn |
| Muốn tự động chọn LLM rẻ/đắt cho AI Agent | ✅ Jev Router (không phải Jev) |
| Bài toán hẹp, đã có classifier chuyên dụng được huấn luyện sẵn | ❌ Không cần System One Model — giữ classifier cũ |
| Muốn tiết kiệm tiền so với Jev | ❌ Đừng chạy local vì lý do này — chênh lệch quá nhỏ |
Checklist bắt đầu
- Nếu chưa có quyền truy cập TypeSafe, dùng OpenRouter để thử ngay hôm nay — không cần chờ waitlist.
- Dựng node
Configở đầu workflow, đưa base URL / model / tên nguồn vào đó. Đừng hard-code. - Benchmark trên tiếng Việt: 200–500 mẫu có nhãn, chạy qua ít nhất hai ứng viên (ví dụ Jev và Nimble), so sánh cả độ chính xác lẫn calibration.
- Chốt ngưỡng riêng cho từng model, lưu thành bảng tra theo trường
nguontự đặt. - Dựng nhánh dự phòng bằng
On Error: Continue (using error output)— local trước, cloud sau (hoặc ngược lại, tuỳ chính sách dữ liệu). - Log
usage.cost(OpenRouter) hoặcusage.input_tokensvào Sheets để theo dõi chi phí thật theo từng workflow. - Pin version ở mọi nơi:
typesafe/jev-1.13,jev-1.13.0, tag Ollama cụ thể. Không dùnglatestở production.
Kết
Ba tuần trước, Jev là một sản phẩm thú vị nhưng rủi ro: đóng, một nhà cung cấp, phải chờ waitlist. Giờ nó đã thành một thể loại: có bản cloud rẻ, bản cloud nhìn được ảnh, bản chạy trên laptop, bản chạy trên CPU — và quan trọng nhất, phần lớn trong số đó nói chung một giao thức.
Với người build n8n, điều này thay đổi cách thiết kế workflow: đừng gắn chặt vào một provider, hãy gắn vào giao thức. Đổi provider chỉ mất 30 giây.
Nhưng đổi niềm tin thì không nhanh như vậy. Con số confidence — lý do đáng dùng nhất của cả thể loại model này — chỉ có giá trị khi bạn đã đo nó trên dữ liệu của chính mình, cho từng model một. Và với tiếng Việt, cho tới hôm nay, vẫn chưa ai đo hộ bạn.
Tài liệu tham khảo
- Jev Tutorial — Make Your First Decision Call on OpenRouter
- TypeSafe models on OpenRouter
- OpenRouter on X — Introducing typesafe/jev-router
- Ollama now supports Jev-style decision models — Ollama Blog
- nimble — Ollama Library
- tev1 — Ollama Library
- Decisions API guide — OpenAI Docs
- Decisions API is now available in Public Beta — OpenAI Developer Community
- Laya — GitHub (NandhaKishorM/laya)
- Benchmarking AI decision models against traditional guardrails — Red Hat Developer
- Jev, A Classification Model, Takes the Developer World By Storm, Spawns Imitators — The Batch
- HTTP Request node — n8n Docs
- Error handling — n8n Docs