Jev & System One Model: “IF Thông Minh” Nhanh Gấp 200 Lần LLM
Có một chuyện mình tin là bạn cũng từng gặp nếu đã build workflow AI trên n8n được vài tháng.
Bạn có một workflow xử lý ticket hỗ trợ khách hàng. Trong đó có đúng một chỗ cần AI: đọc nội dung ticket rồi quyết định nó thuộc nhóm nào — Kỹ thuật, Thanh toán, hay Bán hàng. Chỉ có thế. Một câu hỏi, ba đáp án.
Và để trả lời câu hỏi bé tí đó, bạn phải gọi một con LLM khổng lồ. Nó nghĩ 3 giây. Nó trả về một đoạn string mà bạn phải parse. Thỉnh thoảng nó trả về "Kỹ thuật." kèm dấu chấm, hoặc "Category: Technical", hoặc tử tế hơn thì trả về JSON nhưng thiếu dấu ngoặc. Bạn nhét thêm Structured Output Parser, viết thêm node Code để dọn dẹp. Và quan trọng nhất: bạn không có cách nào biết được nó đang chắc chắn hay đang đoán bừa.
Ngày 15/9/2026 vừa rồi, một startup tên TypeSafe AI ra mắt thứ được họ gọi là System One Model — và model đầu tiên tên là Jev. Nó được sinh ra để làm đúng cái việc bé tí ở trên, và không làm gì khác.
Bài này mình sẽ mổ xẻ xem Jev thực sự là gì, chỗ nào trong n8n nên dùng nó, chỗ nào tuyệt đối không nên — và một giới hạn khá lớn mà người dùng Việt Nam cần biết trước khi hào hứng.
System One Model là gì?
Cái tên lấy từ cuốn Thinking, Fast and Slow của Daniel Kahneman. Kahneman chia tư duy con người làm hai hệ:
- System 1 — nhanh, tự động, trực giác. Nhìn một khuôn mặt là biết đang giận. Không cần suy luận.
- System 2 — chậm, có chủ đích, tốn sức. Nhân 17 × 24 trong đầu.
Luận điểm của TypeSafe khá sắc: toàn bộ ngành AI mấy năm qua chỉ tối ưu cho System 2 — model biết suy luận dài, viết luận văn, chain-of-thought hàng nghìn token. Còn phần System 1 — những quyết định nhỏ, nhanh, xảy ra hàng triệu lần bên trong phần mềm — thì vẫn đang bị phục vụ bằng đúng cái công cụ sai: một con model được thiết kế để nói chuyện với con người.
Người sáng lập TypeSafe, Diogo Almeida, trước đó làm tại OpenAI và tham gia xây dựng chính phần nghiên cứu đứng sau ChatGPT. Câu hỏi mở đầu bài blog ra mắt của ông ấy đọc khá thấm:
“Models have been superhuman at chat for years, so where is all the automation?”
— Diogo Almeida, TypeSafe AI (15/9/2026)
Dịch thoáng: model giỏi chat hơn người từ lâu rồi, vậy tự động hoá đâu hết rồi?
Còn cái tên Jev thì đặt theo William Stanley Jevons — nhà kinh tế học nổi tiếng với nghịch lý Jevons: khi động cơ hơi nước trở nên hiệu quả hơn, lượng than tiêu thụ không giảm mà tăng vọt, vì giá rẻ mở ra vô số ứng dụng mới. TypeSafe đặt cược rằng trí tuệ máy cũng vậy: mỗi lần chi phí giảm một bậc, số lượng use case lại tăng vài bậc.
Jev khác LLM ở chỗ nào?
Cách dễ hình dung nhất: Jev không phải là một con LLM nhỏ hơn. Nó là một cái hàm.
Bạn đưa vào một “state” (dữ liệu thô: nội dung ticket, JSON đơn hàng, transcript hội thoại) và một tập câu hỏi có kiểu dữ liệu định nghĩa sẵn. Nó trả về đáp án đúng kiểu đó, kèm xác suất. Không văn xuôi, không lời chào, không “Chắc chắn rồi! Đây là phân loại của bạn:”.
| LLM thông thường | Jev (System One Model) | |
|---|---|---|
| Đầu ra | String — linh hoạt vô hạn, nhưng phải parse và validate | Giá trị có kiểu, định nghĩa trước. Không thể sinh ra giá trị ngoài schema |
| Cách sinh | Tuần tự, từng token một, token sau phụ thuộc token trước | Song song — sinh toàn bộ đáp án trong một lượt |
| Độ trễ | 3 – 329 giây (model frontier, tính cả reasoning) | 70 – 500 mili-giây |
| Giá input | $0.20 – $10 / triệu token | $0.042 / triệu token |
| Giá output | Thường đắt gấp ~5 lần input | Miễn phí |
| Độ tin cậy | Có hỏi thì nó cũng đưa ra con số, nhưng thường overconfident và không nhất quán | Calibrated — xác suất cao thật sự đồng nghĩa với độ chính xác cao hơn |
| Lỗi kiểu dữ liệu | Vẫn xảy ra, kể cả với structured output | 0% — theo TypeSafe là bất khả thi về mặt toán học |
Cái ý “không thể sinh ra giá trị ngoài schema” là điểm mấu chốt. Với LLM, structured output là một lời hứa — model được prompt để trả JSON đúng schema, và thường thì nó làm được. Với Jev, structured output là kiến trúc — model chỉ có khả năng phân bổ xác suất lên các đáp án bạn đã liệt kê sẵn, nó không có cơ chế nào để tạo ra một chuỗi ký tự mới.
Nếu bạn đã đọc bài Deterministic Core, Agentic Shell, thì đây chính xác là thứ còn thiếu trong bức tranh đó: một cách để phần Core ra được quyết định “mờ” mà vẫn giữ tính tất định về mặt kiểu dữ liệu. Không phải kéo Shell vào giữa lõi nữa.
Ba loại câu hỏi bạn hỏi được
Jev không có “prompt” theo nghĩa thông thường. Nó có state và questions. Mỗi câu hỏi thuộc một trong ba kiểu:
| Kiểu | Dùng khi | Trả về |
|---|---|---|
| Noul | Câu hỏi có/không | Một xác suất từ 0 đến 1 |
| Choice | Chọn 1 trong N nhãn (tối đa 255 nhãn) | Nhãn được chọn + xác suất từng nhãn + confidence |
| Score | Chấm điểm theo thang có thứ tự (2–10 mức) | Điểm trung bình theo xác suất + phân phối + confidence |
Một request gọi API trông như sau:
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer <TYPESAFE_API_KEY>

{
  "model": "jev-latest",
  "state": "Em chào shop, em đặt đơn 3 hôm rồi mà chưa thấy mã vận đơn, em cần gấp trước thứ 6 ạ",
  "questions": {
    "phan_loai": {
      "type": "choice",
      "instructions": "Ticket này thuộc bộ phận nào?",
      "criteria": {
        "ky_thuat": "Lỗi sản phẩm, lỗi hệ thống, không đăng nhập được",
        "thanh_toan": "Hoá đơn, hoàn tiền, thẻ, chuyển khoản",
        "van_don": "Tình trạng đơn hàng, giao hàng, mã vận đơn",
        "other": null
      }
    },
    "khan_cap": {
      "type": "noul",
      "instructions": "Khách có thể hiện sự gấp gáp hoặc ràng buộc về thời gian không?"
    },
    "muc_do_buc_xuc": {
      "type": "score",
      "instructions": "Mức độ bức xúc của khách hàng",
      "criteria": ["Bình thường", "Hơi khó chịu", "Bực bội rõ rệt", "Rất giận dữ"]
    }
  }
}
Và response:
{
  "model": "jev-1.13.0",
  "answers": {
    "phan_loai": {
      "type": "choice",
      "choice": "van_don",
      "probabilities": {
        "van_don": 0.94,
        "thanh_toan": 0.04,
        "ky_thuat": 0.01,
        "other": 0.01
      },
      "confidence": 0.94
    },
    "khan_cap": { "type": "noul", "noul": 0.97 },
    "muc_do_buc_xuc": { "type": "score", "score": 1.2, "confidence": 0.81 }
  },
  "usage": { "input_tokens": 210, "output_tokens": 31 }
}
💡 Chi tiết quan trọng nhất của cả bài: ba câu hỏi ở trên được đánh giá song song trong cùng một lần gọi. Thêm câu hỏi thứ tư, thứ năm, thứ mười gần như không làm tăng thời gian phản hồi. Đây là điểm đảo ngược hoàn toàn thói quen khi làm việc với LLM — ở đó mỗi câu hỏi thêm vào là thêm token, thêm thời gian, thêm tiền. Với Jev, bạn nên hỏi nhiều câu nhỏ, độc lập, rõ ràng thay vì một câu to nhập nhằng.
Gọi Jev trong n8n như thế nào?
Cách 1: HTTP Request node (luôn dùng được)
Đây là cách mình khuyên dùng đầu tiên, vì nó chạy trên mọi phiên bản n8n — cloud hay self-host, không cần cài gì thêm.
- Thêm node HTTP Request
- Method:
POST, URL:https://api.typesafe.ai/v1/systemone - Authentication → Generic Credential Type → Header Auth, header
Authorizationvới giá trịBearer <API key của bạn> - Body: JSON, dán cấu trúc
state+questionsnhư trên, dùng expression để nhét dữ liệu thật vàostate:
{
  "model": "jev-latest",
  "state": {{ JSON.stringify($json.noi_dung_ticket) }},
  "questions": { ... }
}
Kết quả trả về nằm gọn trong $json.answers, và bạn truy cập trong node sau bằng expression bình thường:
// Nhãn được chọn
{
  {
    $json.answers.phan_loai.choice;
  }
}

// Độ tin cậy — đây mới là thứ đáng giá
{
  {
    $json.answers.phan_loai.confidence;
  }
}

// Xác suất của riêng một nhãn
{
  {
    $json.answers.phan_loai.probabilities.van_don;
  }
}
Cách 2: Community node
Cộng đồng n8n đã có node riêng cho Jev, ví dụ n8n-nodes-jev-classification (Settings → Community Nodes). Node này bọc sẵn các thao tác Classify / Score / Check / Ask Questions, và tiện nhất là chế độ Route by Choice: mỗi nhãn trở thành một output riêng trên canvas, cộng thêm một output “Needs Review” cho các item dưới ngưỡng confidence. Nói cách khác, nó biến thành một node Switch mà phần quyết định do AI lo.
⚠️ Lưu ý: community node chưa được n8n verify thì chỉ cài được trên bản self-host. Nếu bạn đang dùng n8n Cloud, quay lại cách 1. Và như mọi community node khác — trước khi đưa vào production, hãy tự đọc source và pin version lại.
Bốn chỗ nên thay LLM bằng Jev trong workflow n8n
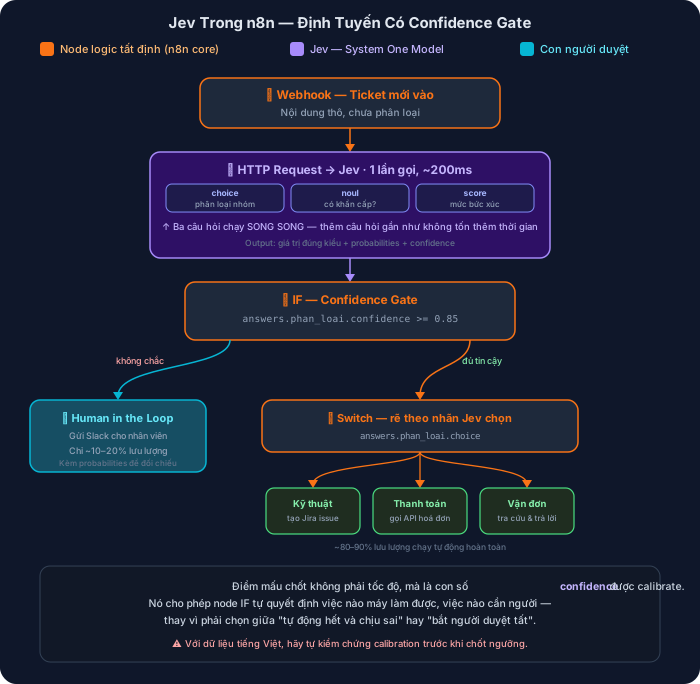
1. Định tuyến thông minh — thay thế Text Classifier
Đây là use case hiển nhiên nhất. Node Text Classifier của n8n bản chất là gọi LLM để chọn một nhãn. Jev làm đúng việc đó, nhanh hơn hai bậc và rẻ hơn hai bậc.
Pattern trong n8n: Trigger → HTTP Request (Jev) → Switch (rẽ theo {{ $json.answers.phan_loai.choice }}).
Điểm cộng thêm mà Text Classifier không cho bạn: trong cùng một lần gọi, bạn hỏi luôn “có khẩn cấp không”, “khách bực đến mức nào”, “có nhắc tới đối thủ không”, “có dấu hiệu muốn huỷ dịch vụ không”. Năm câu hỏi, một request, vẫn dưới 500ms. Với LLM thì đó là năm lần gọi hoặc một prompt dài loằng ngoằng.
2. Confidence gate — Human-in-the-Loop đúng nghĩa
Với mình đây mới là tính năng đáng tiền nhất, và nó không nằm ở tốc độ.
Vấn đề kinh điển khi tự động hoá bằng LLM: model đúng 95% số lần, nhưng nó không nói cho bạn biết lần này có nằm trong 5% kia hay không. Thế là bạn kẹt giữa hai lựa chọn tệ: hoặc tự động hoá hết rồi chấp nhận 5% sai lọt ra ngoài, hoặc bắt người duyệt 100% — và mất luôn ý nghĩa của việc tự động hoá.
Xác suất calibrated của Jev cắt được nút thắt này. “Calibrated” nghĩa là: trong tập các item mà model báo confidence 0.9, thì khoảng 90% thực sự đúng. Con số đó dùng được để ra quyết định, khác hẳn với việc hỏi LLM “bạn chắc chắn bao nhiêu phần trăm?” rồi nhận về một con số 95% được bịa ra cho có.
Pattern trong n8n:
HTTP Request (Jev)
   └─> IF: {{ $json.answers.phan_loai.confidence >= 0.85 }}
          ├─ true  → Switch → xử lý tự động hoàn toàn
          └─ false → Slack / Human-in-the-Loop node → người duyệt
Kết quả: bạn tự động hoá được 80–90% lưu lượng với độ chính xác cao, và chỉ phần thực sự mơ hồ mới tốn thời gian của con người. Đây chính là “ranh giới” mà bài Deterministic Core, Agentic Shell nói tới, giờ có thêm một núm vặn định lượng thay vì chỉ là chỗ chặn cứng.
💡 Ngưỡng
0.85ở trên là ví dụ. Cách làm đúng: chạy Jev song song với quy trình hiện tại khoảng 1–2 tuần, log lạiconfidencevà kết quả thực tế, rồi chọn ngưỡng dựa trên số liệu của chính bạn. Và khi đã chốt ngưỡng, hãy pin version model (jev-1.13.0) thay vì đểjev-latest— chính TypeSafe khuyến nghị vậy, vì model nâng cấp có thể làm dịch chuyển phân phối confidence.
3. Guardrail trước hành động không thể đảo ngược
Trong bài trước mình có nói: đừng bao giờ để AI Agent tự ý thực hiện hành động không thể hoàn tác. Nhưng chặn bằng Wait node thì mọi thứ đều phải chờ người — kể cả 95% trường hợp hoàn toàn vô hại.
Jev cho bạn một lớp lọc ở giữa. Trước node Gmail, node xoá record, hay node gọi API thanh toán, chèn một lần gọi Jev để chấm điểm rủi ro của hành động sắp thực hiện:
{
  "risk": {
    "type": "score",
    "instructions": "Mức độ rủi ro nếu thực hiện hành động này mà không có người duyệt",
    "criteria": [
      "An toàn, đảo ngược được",
      "Cần chú ý",
      "Nguy hiểm, không đảo ngược được"
    ]
  },
  "co_du_lieu_nhay_cam": {
    "type": "noul",
    "instructions": "Nội dung có chứa thông tin cá nhân, thông tin thanh toán hay credential không?"
  }
}
Tốn thêm ~100ms và khoảng 0.0001 đô cho mỗi lần chạy. Việc này với LLM thì quá chậm và quá đắt để đặt trên mọi lần gọi — mà guardrail thì chỉ có ý nghĩa khi nó chạy trên mọi lần gọi.
4. Xử lý dữ liệu lớn — thứ mà LLM không kham nổi
Bạn có 50.000 dòng phản hồi khách hàng trong Google Sheets và muốn gán nhãn sentiment + chủ đề cho từng dòng.
Với LLM: Loop Over Items chạy 50.000 vòng, mỗi vòng 3 giây → hơn 41 tiếng, chưa kể tiền và rate limit. Thực tế là không làm được, nên hầu hết mọi người bỏ luôn ý tưởng.
Với Jev: rate limit công bố là 1.200 request/phút, mỗi request dưới nửa giây. Cùng khối lượng đó xuống còn khoảng 40 phút, chi phí vài đô. Đây là loại workflow mà trước đây bạn không nghĩ tới vì nó bất khả thi — chứ không phải bạn đang tối ưu một thứ sẵn có.
Kết hợp thêm: dùng Jev để lọc, rồi chỉ đẩy phần đáng chú ý cho LLM viết báo cáo tổng hợp. Jev làm phần “đọc hết”, LLM làm phần “viết ra”. Mỗi model làm đúng việc của nó.
Chuyện tiền nong
Lấy một ví dụ dễ hình dung: 100.000 ticket mỗi tháng, mỗi ticket khoảng 1.000 token input.
- Tổng: 100 triệu input token
- Giá Jev: $0.042 / triệu token → $4.20/tháng (khoảng 110.000đ)
- Output: miễn phí
TypeSafe công bố trên trang chủ con số 193.6x nhanh hơn và 444.6x rẻ hơn so với LLM trên bộ workflow eval của họ. Cứ cho là con số marketing đi, thì ngay cả khi thực tế chỉ đạt một nửa, khoảng cách vẫn đủ lớn để thay đổi cách bạn thiết kế workflow — không còn phải đắn đo “có đáng gọi AI ở bước này không”.
Mà thật ra tác động lớn nhất không nằm ở chỗ tiết kiệm. Nó nằm ở chỗ mở ra những workflow trước đây không tồn tại: chấm điểm mọi lead ngay khi vừa vào form, guardrail trên mọi lần agent gọi tool, phân loại mọi dòng log theo thời gian thực. Đúng tinh thần nghịch lý Jevons mà họ lấy làm tên model.
Và giờ là phần không màu hồng
Mình viết phần này dài, vì hầu hết bài giới thiệu Jev trên mạng đang bỏ qua nó.
⚠️ Tiếng Việt: giới hạn lớn nhất với chúng ta
Tài liệu chính thức của TypeSafe nói thẳng:
“English is the primary training language and where accuracy is currently best. Other languages, including CJK scripts, are handled but not equally well.”
— TypeSafe AI Docs, trang Models
Tiếng Anh là ngôn ngữ huấn luyện chính và là nơi độ chính xác tốt nhất. Các ngôn ngữ khác có xử lý được, nhưng không tốt bằng. Tiếng Việt thậm chí không nằm trong nhóm được nêu tên cụ thể.
Nghĩa là toàn bộ những con số đẹp ở trên đều được đo trên dữ liệu tiếng Anh. Nếu workflow của bạn xử lý ticket tiếng Việt, comment Facebook tiếng Việt, hay tin nhắn Zalo — bạn bắt buộc phải tự benchmark trước khi tin. Cách làm cụ thể:
- Lấy 200–500 mẫu thật đã được gán nhãn tay từ hệ thống của bạn
- Chạy qua Jev, so sánh nhãn dự đoán với nhãn thật
- Quan trọng hơn cả độ chính xác: kiểm tra xem confidence có calibrated trên tiếng Việt không. Nhóm item có confidence ≥ 0.9 có thực sự đúng ~90% không? Nếu không, thì cái confidence gate ở mục 2 phía trên mất luôn giá trị — mà đó lại chính là lý do đáng dùng Jev nhất.
- Một mẹo đáng thử nếu kết quả tiếng Việt yếu: viết phần
instructionsvàcriteriabằng tiếng Anh, giữ nguyênstatetiếng Việt. Thường cải thiện được, nhưng vẫn phải đo lại.
“Không hallucinate” không có nghĩa là “không sai”
Đây là hiểu lầm phổ biến nhất về Jev, và nó nguy hiểm.
Jev đảm bảo không bao giờ trả về giá trị nằm ngoài schema của bạn. Nếu bạn định nghĩa 3 nhãn, nó luôn trả về một trong 3 nhãn đó. Đảm bảo này là về kiểu dữ liệu, không phải về tính đúng đắn.
Nó vẫn hoàn toàn có thể chọn thanh_toan trong khi đáp án đúng là ky_thuat, và chọn một cách rất tự tin. Bạn loại bỏ được cả một lớp lỗi kỹ thuật (parse lỗi, sai kiểu, JSON hỏng) — nhưng lỗi phán đoán thì vẫn còn nguyên. Đừng bỏ logic kiểm tra chỉ vì “model này không hallucinate”.
Benchmark hiện tại đều do chính TypeSafe chạy
Con số ~68% trên bộ workflow eval của họ có mấy điểm cần lưu ý, mà đáng khen là chính TypeSafe cũng tự nêu ra trong bài blog:
- Đáp án tham chiếu không phải ground truth. Họ lấy trung bình dự đoán của GPT-6 Astra và Fable 5.1 làm chuẩn. Tức là đang đo “giống model lớn đến đâu”, không phải “đúng đến đâu”.
- Bộ eval do chính đội ngũ của họ tạo ra. Họ thừa nhận có thể tồn tại thiên lệch.
- Chưa có benchmark công khai độc lập nào. Early access mới mở, chưa ai kiểm chứng ở quy mô production.
Nói ngắn gọn: các claim về tốc độ và giá thì dễ tự kiểm chứng (bạn gọi thử là biết). Claim về độ thông minh thì hãy đợi bên thứ ba, hoặc tự đo trên dữ liệu của mình.
Những giới hạn kỹ thuật cần nhớ
| Giới hạn | Con số |
|---|---|
| Số lựa chọn tối đa | 255 nhãn cho một câu choice |
Số mức của score |
2 – 10 |
| Context | 64k token/request; 32k cho state + câu hỏi dài nhất |
| Đầu vào | Chỉ text. Không ảnh, không audio, không video |
| Không làm được | Sinh văn bản, viết code, tính toán số học, đếm |
| Rate limit | 250.000 token/giây, 1.200 request/phút |
| Tình trạng | Early access, phải đăng ký waitlist |
Cái “chỉ text, không ảnh” đáng chú ý với dân n8n: workflow xử lý ảnh hoá đơn, chụp màn hình lỗi, ảnh sản phẩm thì Jev chưa vào được. Còn “không đếm, không tính toán” thì đừng hỏi nó “có bao nhiêu sản phẩm trong đơn này” — cái đó để node Code làm, chính xác 100% và miễn phí.
Và một rủi ro kiểu vận hành
Jev là dịch vụ đóng, của một công ty mới, đang early access, chỉ có một nhà cung cấp. Không có bản self-host, không có model thay thế tương đương để fallback. Nếu bạn đã đọc bài tích hợp n8n với Ollama và quan tâm chuyện dữ liệu không rời khỏi máy mình, thì đây là bước đi ngược hướng hoàn toàn.
Lời khuyên thực dụng: đừng để workflow chết nếu Jev chết. Trong n8n, bật Continue On Fail cho node HTTP Request, và thiết kế nhánh dự phòng — rơi về node Text Classifier cũ, hoặc đơn giản là đẩy hết vào hàng đợi review thủ công. Coi Jev như một lớp tăng tốc, không phải một trụ chống đỡ.
Vậy rốt cuộc, khi nào dùng?
| Tình huống trong n8n | Dùng gì |
|---|---|
| Phân loại, định tuyến, chấm điểm, kiểm tra có/không | ✅ Jev |
| Cần biết mức độ chắc chắn để quyết định có cần người duyệt không | ✅ Jev (điểm mạnh nhất) |
| Guardrail chạy trên mọi lần gọi | ✅ Jev |
| Gán nhãn hàng chục nghìn bản ghi | ✅ Jev |
| Viết email, tóm tắt, dịch, sinh nội dung | ❌ LLM (Basic LLM Chain) |
| Suy luận nhiều bước, tự gọi tool, tự lên kế hoạch | ❌ LLM (AI Agent — xem AI Agent là gì) |
| Trích xuất thông tin thành văn bản tự do | ❌ LLM (Information Extractor) |
| Xử lý ảnh, file, âm thanh | ❌ LLM đa phương thức |
| Tính toán, đếm, xử lý số | ❌ Node Code — nhanh hơn, đúng 100%, miễn phí |
Một nguyên tắc đơn giản để nhớ: nếu bạn đang gọi AI chỉ để lấy về một giá trị mà bạn có thể liệt kê trước tất cả đáp án — đó là việc của Jev. Nếu đáp án là một đoạn văn bản mà bạn không đoán trước được — đó là việc của LLM.
Checklist bắt đầu
- Đăng ký waitlist tại typesafe.ai — hiện vẫn đang early access.
- Tìm một node LLM trong workflow hiện có mà output chỉ là một nhãn. Đó là ứng viên đầu tiên, rủi ro thấp nhất.
- Chạy song song, đừng thay thế ngay. Dùng nhánh phụ gọi Jev, ghi kết quả vào Sheets cạnh kết quả cũ, so sánh trong 1–2 tuần.
- Kiểm tra calibration trên dữ liệu tiếng Việt của bạn trước khi tin vào ngưỡng confidence. Đây là bước không được bỏ qua.
- Chốt ngưỡng, pin version model, dựng nhánh fallback, rồi mới chuyển luồng chính sang.
- Gộp câu hỏi. Khi đã chạy, hỏi thêm 5–10 câu trong cùng request — gần như miễn phí về thời gian, và cho bạn dữ liệu để làm những thứ tinh vi hơn về sau.
Kết
Jev không phải là một con LLM tốt hơn. Nó là lời thừa nhận rằng phần lớn công việc AI bên trong phần mềm chưa bao giờ cần tới một con LLM — chúng ta dùng LLM vì đó là thứ duy nhất có sẵn.
Với người build workflow n8n, mình nghĩ đây là hướng đi rất đáng theo dõi. Nó khớp gần như hoàn hảo với triết lý mà n8n vốn có từ đầu: luồng chạy thì tường minh và tất định, AI chỉ được gọi đúng chỗ cần đến sự mơ hồ. Jev không kéo AI ra khỏi lõi — nó khiến việc đặt AI vào trong lõi trở nên an toàn, vì lần đầu tiên bạn có một lớp AI trả lời đúng kiểu dữ liệu và biết tự nói “tôi không chắc”.
Còn phần thận trọng thì vẫn giữ nguyên: early access, benchmark chưa độc lập, và tiếng Việt chưa phải sân nhà của nó. Cứ thử — nhưng thử ở nhánh phụ, với dữ liệu của chính bạn, và đo trước khi tin.
Tài liệu tham khảo
- Introducing System One Models & Jev — TypeSafe AI Blog
- TypeSafe AI Docs — Models (giới hạn, ngôn ngữ, version)
- What Everyone Is Getting Wrong About TypeSafe AI’s Jev — KDnuggets
- TypeSafe AI’s Jev: What “System One Models” Actually Are — TrueFoundry
- Building a harness with Jev — LangChain Blog
- Community node: Jev Classification for n8n — n8n Community
- Text Classifier node — n8n Docs
- HTTP Request node — n8n Docs